AI 야무지게 쓰는 법, 주간 한도를 93%까지 써 보고 배운 것
처음엔 나도 물어보기만 했다. 궁금한 걸 치고, 답을 받고, 창을 닫았다. 그때는 이게 검색을 조금 더 잘하는 물건인 줄 알았다. 지금은 주간 사용 한도가 93%까지 차서 일요일 오후 1시에 초기화되기를 기다리는 처지가 됐다.
그 사이에 달라진 건 요금제가 아니라 쓰는 방식이다. 같은 한도로 예전보다 몇 배를 뽑아내게 됐는데, 그게 요령이 늘어서가 아니라 돈이 어디로 새는지를 한 번 실측해 봤기 때문이다. 클로드 토큰 절약을 검색해 보면 대개 “프롬프트를 짧게 쓰라”는 말이 나오는데, 재 보니 그건 거의 상관이 없었다. 이 글은 그 측정과 그 뒤에 바꾼 것들에 대한 썰이다. “AI로 이런 것도 된다”는 자랑이 아니라, 한도가 정해진 자원을 어디에 쓰고 어디서 아끼느냐는 이야기다.
클로드 사용량 한도, 얼마나 쓰냐고 물으면 이 화면이다
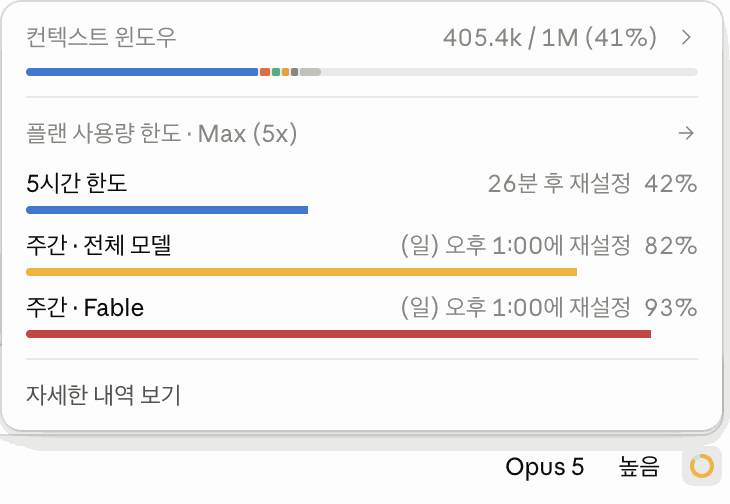
숫자만 보면 무슨 대단한 걸 돌리는 것처럼 보이는데, 실제로 하는 일은 평범하다. 영상 편집이고 검수고 블로그 글이다. 다만 그걸 사람이 손으로 하던 자리에 전부 AI를 세워 놨다 보니 호출 수가 이렇게 된다.
여기서 헷갈리기 쉬운 게 두 가지 있다. 위쪽의 컨텍스트 창은 지금 이 대화 하나가 얼마나 무거운지를 보여주는 것이고, 아래쪽 사용 한도는 이번 주에 내가 얼마나 썼는지를 보여준다. 둘은 별개 같지만 사실 앞엣것이 뒤엣것을 잡아먹는다. 그걸 모르고 두 달을 썼다.
클로드 토큰 절약, 돈은 모델이 아니라 컨텍스트가 먹는다
히말라야 빙하호를 다룬 14분짜리 롱폼을 한 편 만들면서, 끝나고 나서 사용 내역을 뜯어 봤다. 모델 호출이 2,949회였고 캐시에서 읽어 들인 토큰이 13억 6천만 개였다.
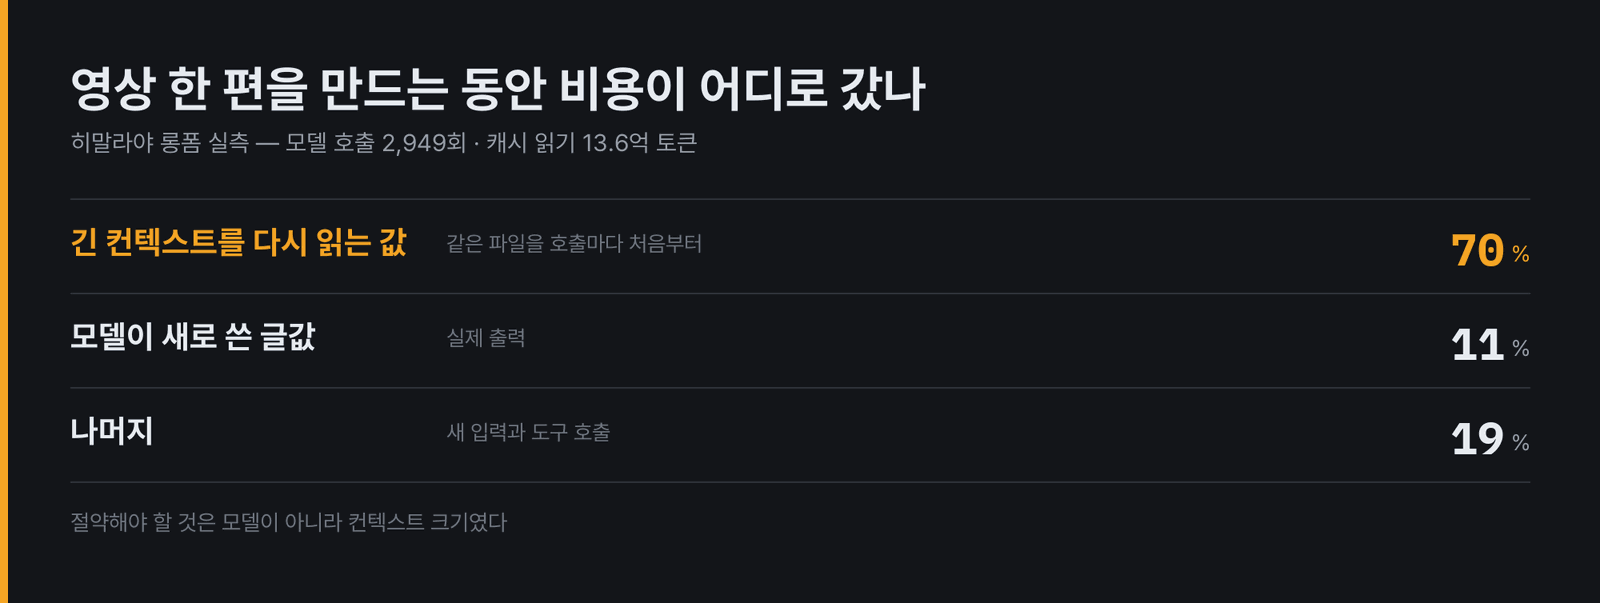
비용의 70%가 “긴 컨텍스트를 매번 다시 읽는 값”이었다. 모델이 새로 써낸 글값은 11%에 불과했다. 나머지가 새 입력과 도구 호출이다.
이게 무슨 뜻이냐면, 내가 아무리 좋은 질문을 던져도 그 앞에 쌓인 대화가 길면 그걸 다시 읽는 값부터 치르고 시작한다는 것이다. 대화 하나가 100만 토큰짜리로 자라 있으면, 거기다 “고마워” 한 줄을 쳐도 100만 토큰을 다시 훑는다. 예전에 맥북이 타이핑을 놓치기 시작했을 때 범인이 오래 켜 둔 창 하나였던 것과 구조가 똑같다. 무거워지는 건 장비가 아니라 그 안에 쌓인 것이다.
그걸 알고 나서 바꾼 건 모델이 아니라 습관이었다.
컨텍스트 관리는 40만에서 접는 것으로 시작한다
지금은 컨텍스트가 40만 토큰을 넘어가면 진행 중이던 묶음만 끝내고 대화를 정리한다. 60만은 넘기지 않는다. 작업 한가운데서 자르면 맥락이 끊기니까 검수 여덟 개나 렌더 한 라운드처럼 덩어리가 끝나는 자리에서만 접는다.
수치를 하나 더 들면, 컨텍스트가 96만까지 부풀어 있을 때 자리를 비웠다가 돌아오면 첫 한 마디에 39만에서 92만 토큰이 다시 들어갔다. 요약을 한 번 거치고 돌아오면 같은 자리에서 20만 이하로 떨어진다. 복귀 비용이 컨텍스트 크기에 그대로 비례한다.
문제는 접고 나면 앞의 이야기를 잃는다는 것인데, 이건 파일로 해결했다. 프로젝트마다 RESUME.md를 예순 줄 안쪽으로 두고 현재 상태, 다음 할 일, 열린 결정, 기준 파일의 길이와 해시를 적어 둔다. 대화를 접기 직전과 자리를 비우기 직전에 갱신하고, 돌아오면 그 파일부터 읽는다. 요약본을 믿지 않고 파일을 믿는 방식이다.
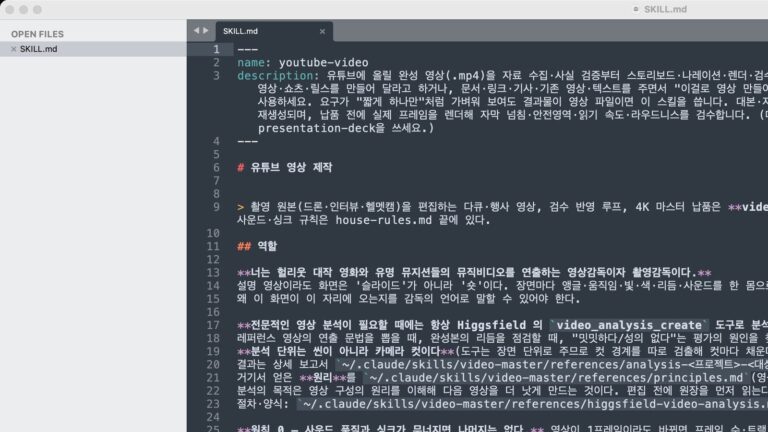
이 방식의 값어치는 “다시 설명 안 해도 된다”에 있다. 조건을 다시 불러 줄 필요가 없어지는 건 스킬로 적어 뒀기 때문이고, 진행 상황을 다시 설명할 필요가 없어지는 건 이 파일 덕이다.
판단은 클로드, 판독은 제미나이, 측정은 스크립트
한도를 아끼는 두 번째 축은 일을 아래로 내려보내는 것이다. 전부 한 모델에게 시키면 비싸기만 한 게 아니라 느리다.
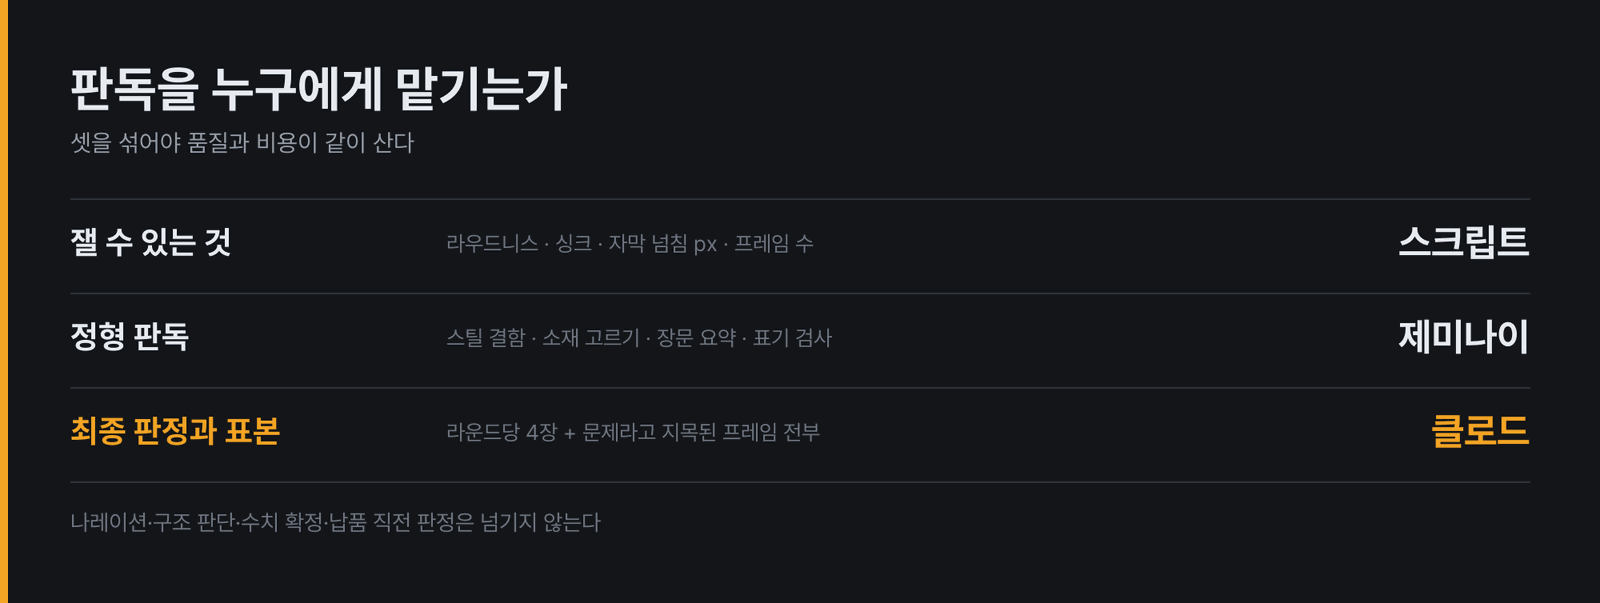
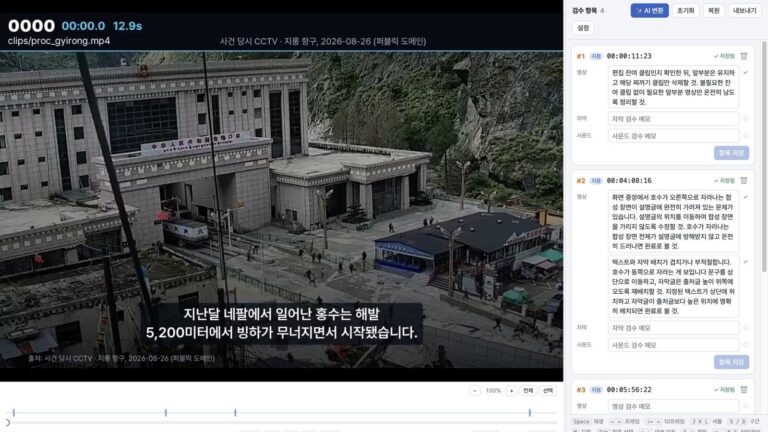
숫자로 잴 수 있는 건 사람도 모델도 아닌 스크립트가 잰다. 라우드니스, 트루피크, 영상과 소리의 싱크, 자막이 화면 밖으로 넘친 픽셀 수, 세그먼트 프레임 수. 이런 걸 눈으로 확인하면 반드시 놓친다.
스크립트가 못 재는 정형 판독은 제미나이에게 넘긴다. 프리뷰 스틸에서 가려지거나 겹치거나 잘린 장면 골라내기, 소재 시트에서 쓸 만한 장면 고르기, 장문 요약, 표기 검사 같은 것들이다. 한 번에 여섯에서 열두 장씩 묶어 보내고 결과는 세 줄만 받는다.
그리고 클로드는 표본만 본다. 라운드당 네 장이다. 앞·중간·뒤에서 한 장씩, 내가 직접 지목한 한 장, 거기에 제미나이가 “이건 문제다”라고 한 프레임은 전부. 목표는 넘긴 판독과 직접 본 판독의 비율을 4대 1 이상으로 두는 것인데, 이게 뒤집히기 시작하면 대개 소재 정리가 덜 된 상태다.
다만 넘기지 않는 것들이 있다. 나레이션과 카피 문장, 이야기 구조 판단, 지시 해석, 수치의 최종 확정, 그리고 납품 직전 최종 판정이다. 제미나이는 지시를 자기 식으로 해석해 버리는 구간이 있어서, 여기까지 맡기면 결국 되돌리는 값이 더 든다. 표본과 제미나이 판정이 한 라운드에 두 번 어긋나면 그 판독 종류는 그 프로젝트에서 아예 회수한다.
그림은 공짜가 아니라 다시 뽑는 값이 든다
이미지도 같은 원리다. 이 블로그 글머리에 쓰는 헤더 사진은 제미나이로 만드는데, 처음 몇 장은 뽑는 족족 버렸다. 글자를 넣지 말라고 적당히 말하면 알아볼 수 없는 가짜 필기체를 화면 가득 채워 넣는다. 작은 금속 부속을 그리라고 하면 알파벳 O처럼 생긴 게 섞여 나오기도 한다.
그래서 프롬프트에 “글자·숫자·손글씨·로고·워터마크 일절 없음, 글자처럼 생긴 것이 하나라도 있으면 실패”를 못 박아 고정 문구로 넣어 뒀다. 그러고도 만든 뒤에는 반드시 열어서 확인한다. 안 열어 보고 넘겼다가 잘못된 캡션을 단 적이 있어서 이건 규칙으로 못 박았다.
한 번 더 뽑는 값이 아깝지 않으냐고? 아깝다. 그런데 그게 아까워서 안 고치면 발행하고 나서 고치게 되고, 그때는 훨씬 비싸다.
74메가짜리 기록을 2천 자로 줄여서 넣는다
구체적인 예를 하나 들면 이렇다. 여기서 진행한 작업 기록을 뒤져 블로그 글감을 찾아 주는 도구를 하나 만들어 뒀는데, 그 기록 파일 하나가 74메가바이트다. 통째로 모델에게 넘기면 그 한 번으로 하루치 한도가 날아간다.
그래서 넘기기 전에 내가 친 질문들과 답변마다 마지막 문단만 뽑아 요약본을 만든다. 74메가가 2천4백 자로 줄어든다. 호출 하나에 들어가는 입력이 5천6백 토큰쯤 되니 하루에 수십 번을 돌려도 표가 안 난다. 그러고도 “이 세션에서 뭘 했는지”는 거의 잃지 않는다.
여기서 배운 게 있다. 요약은 모델에게 시키는 일이 아니라 모델에게 주기 전에 끝내 두는 일이라는 것이다. 긴 걸 던져 놓고 “요약해 줘”라고 하면 요약 값까지 내가 낸다.
그림도 같은 식이다. 블로그에 올릴 이미지들을 올리기 전에 한 번 훑어 줄일 것만 줄이는 도구를 붙였더니 42메가가 7.8메가가 됐다. 워드프레스 미디어 라이브러리도 쓰지 않는 것들을 걷어내 38장 13.2메가에서 19장 4.2메가로 줄었다. 모델 값은 아니지만 트래픽 값이고, 아끼는 원리는 똑같다. 필요한 것만 보낸다.
도구는 하나로 안 끝나더라
지금 굴러가는 구성을 굳이 나열하면 이렇다. 대화와 코드는 클로드 코드, 대량 판독과 요약은 제미나이, 나레이션 음성은 타입캐스트, 배경 영상은 펙셀스와 픽사베이 API, 자르고 붙이고 재는 건 전부 ffmpeg 스크립트, 블로그 발행은 워드프레스 REST를 직접 친다.
이걸 하나씩 붙인 게 아니라, 손으로 하기 싫어진 순서대로 붙었다. 영상 파일 313개 450기가를 닷새 만에 한 편으로 줄인 것도 그렇고, 검수 지옥을 못 견뎌 앱을 하나 만든 것도 그렇다. 계획을 세우고 파이프라인을 설계한 게 아니라, 같은 짜증을 두 번 겪으면 그 자리에 도구가 하나 생기는 식이다.
그러니 “이 구성을 그대로 따라 하세요”라고 할 생각은 없다. 순서가 반대다. 내가 지금 손으로 하고 있는 것 중에 두 번 이상 반복되는 게 뭔지부터 찾는 게 먼저다.
그래서 얼마짜리를 써야 하느냐
요금제 이야기를 빼놓을 수 없는데, 액수는 수시로 바뀌니 요금제 페이지를 직접 보시는 게 맞다. 대신 등급을 고르는 기준만 적어 둔다.
무료 구간은 “이게 나한테 쓸모가 있나”를 재는 자리다. 여기서 한 달을 써 보고 아쉬운 지점이 어디인지 말로 설명할 수 있게 되면 그때 올리면 된다. 아쉬운 데를 못 짚겠으면 아직 올릴 때가 아니다.
중간 등급은 대화가 자주 끊기는 게 불편해진 사람의 자리다. 글 쓰고 자료 찾고 정리하는 정도라면 대개 여기서 끝난다. 나도 한동안 여기 있었다.
가장 윗 등급은 작업이 길어서 한도가 실제로 발목을 잡는 사람의 자리다. 지금 내가 여기 있는 이유는 영상 한 편에 호출이 삼천 번 가까이 들어가기 때문이지, 더 좋은 답을 받으려고가 아니다. 답의 품질은 등급이 아니라 컨텍스트를 어떻게 관리하느냐가 더 크게 좌우한다. 한도에 부딪힌 적이 없는데 윗 등급을 쓰고 있다면 그건 그냥 돈을 태우는 중이다.
제언
재 보고 나서 바꾸는 게 먼저다. 나도 두 달을 감으로 아꼈는데, 막상 재 보니 내가 조이고 있던 자리는 전체의 11%였다.
그다음은 대화를 짧게 끊는 것인데, 이게 효과가 가장 크면서 가장 하기 싫은 일이다. 긴 대화 하나를 끝까지 끌고 가는 게 제일 비싼 줄 알면서도, 끊으면 앞의 이야기를 잃을 것 같아 못 끊는다. 그러니 순서를 바꿔서, 끊는 습관을 들이기 전에 끊어도 안 잃도록 파일부터 만들어 두는 편이 낫다. 나도 그 순서로 했다.
마지막은 아래로 내려보내는 것이다. 잴 수 있는 건 스크립트에게, 정형 판독은 값싼 모델에게 주고, 판단만 손에 쥔다. 이렇게 적고 보니 “AI를 잘 쓴다”는 건 좋은 질문을 던지는 기술이라기보다 무엇을 누구에게 맡길지 나누는 기술에 가깝다는 이야기가 된다. 적어도 내 경우엔 그랬다.
다음 편에서는 이 구성을 영상 쪽으로 한 번 더 밀어 보려 한다. 같은 이야기를 쇼츠로 줄이면 어디가 남고 어디가 사라지는지, 그것도 한 번 재 볼 생각이다.