코딩 언어의 마지막 계단은 우리가 매일 쓰는 말이었다
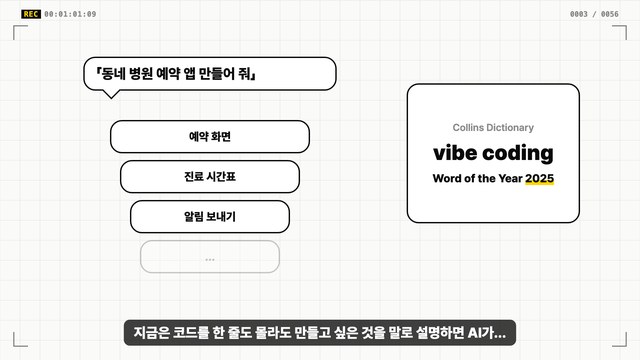
지금은 코드를 한 줄도 몰라도 만들고 싶은 것을 말로 설명하면 AI가 프로그램을 만들어 준다. 필자가 이 글에서 따라가 보려는 것은 이 한 문장이 어디서 왔고, 어디로 이어지는지다.
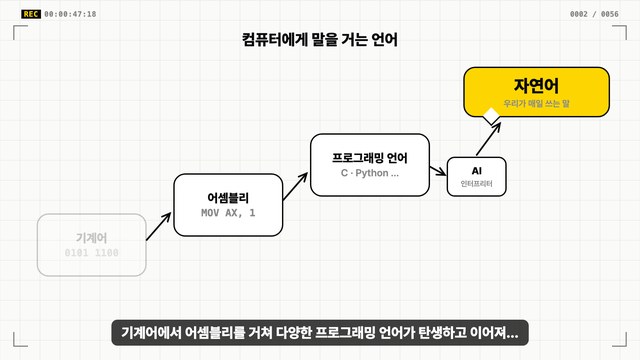
기계에게 일을 시키는 말은 기계어에서 어셈블리를 거쳐 여러 프로그래밍 언어로 이어졌고, 이제 AI를 통해 우리가 쓰는 자연어에 닿았다. 아래 영상의 내용을 이 줄기에 맞춰 다시 배열해 정리했다.
0과 1로만 일을 시킬 수 있던 기계어의 시절
기계가 직접 알아듣는 말이 기계어다. 0과 1의 나열로 이루어져 있어서 기계에게는 가장 빠르고 정확한 말이지만, 사람에게는 외계어에 가깝다. 어떤 숫자 묶음이 무슨 명령인지 외우고 있어야 했고, 한 글자만 틀려도 기계는 엉뚱한 일을 했다.
그래서 이 시절에는 사람이 기계 쪽으로 다가가야 했다. 일을 시키려면 먼저 기계의 말을 배워야 했던 셈이다. 명령하는 언어의 출발점이 여기였다.
기계어에 이름을 붙여 부르게 된 어셈블리의 시절
다음 단계가 어셈블리다. 숫자 묶음 대신 알아볼 만한 짧은 이름으로 명령을 적게 되었다. 기계어를 이름표로 바꿔 적은 것에 가까워서, 여전히 기계의 구조를 잘 알아야 했지만 적어도 사람이 읽을 수는 있었다.
기계의 말과 사람의 말 사이가 처음으로 조금 좁혀진 때다. 영상은 이 기계어와 어셈블리를 묶어 저급 언어로 보여 준다.
사람의 문장을 닮아 가며 갈래를 늘려 온 고급 언어들
이후 다양한 프로그래밍 언어가 탄생하고 이어져 왔다. 명령은 점점 사람의 문장에 가까워졌다. 기계 구조를 하나하나 따지지 않아도 값을 더하거나 조건에 따라 처리하라는 지시를 사람이 쓰는 방식에 가깝게 적을 수 있게 되었다.
그 사이를 이은 것이 번역 도구다. 컴파일러는 글 전체를 한꺼번에 기계어로 옮기고, 인터프리터는 한 줄씩 통역하듯 옮겨 준다. 사람은 사람에 가까운 말로 쓰고 번역은 도구가 맡는 구조가 이때 자리 잡았다. 영상에서는 이 언어들을 고급 언어로 묶고, 앞의 저급 언어와 함께 전통적인 프로그래밍 언어라는 한 덩어리로 보여 준다. 다만 이 단계까지도 문법이라는 규칙은 사람이 익혀야 했다.
AI가 통역을 맡으며 코딩 언어가 된 자연어
영상의 문장 그대로, 기계어에서 어셈블리를 거쳐 다양한 프로그래밍 언어가 이어져 왔듯이 이제는 AI라는 인터프리터를 통해 코딩 언어가 우리의 일반적인 언어인 자연어가 되었다. 번역 도구의 자리를 AI가 맡으면서 마지막 계단이 사람의 말이 된 것이다.
영상은 여기서 코딩 실력도 프로그램을 다루는 기술도 아닌, 일상에서 쓰는 언어능력이 AI에게 일을 시키는 도구라고 짚는다. 이렇게 만드는 방식이 바이브 코딩이고, 영국 콜린스 사전은 이 말을 2025년 올해의 단어로 골랐다.
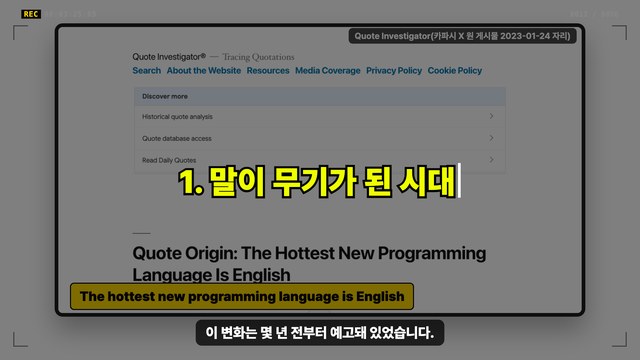
예고는 있었다. 2023년 1월 오픈AI 창립 멤버 안드레이 카파시가 지금 가장 뜨거운 프로그래밍 언어는 영어라고 썼다. 컴퓨터에게 일을 시키는 언어가 코드에서 사람의 말로 옮겨 가고 있다는 뜻이었다. 그리고 2년 뒤 그가 처음 쓴 말이 바이브 코딩이다.
코드를 짤 줄 아는 창업자들마저 말로 만들기 시작한 현장
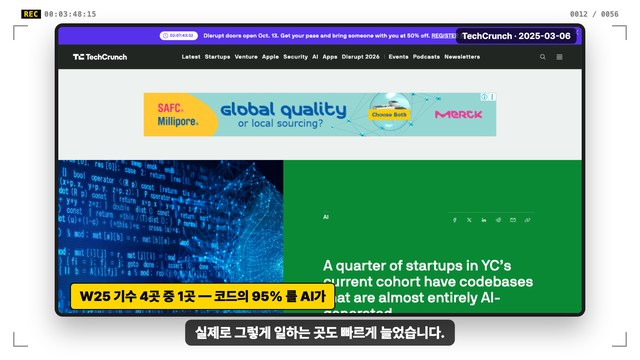
현장은 빠르게 움직였다. 미국의 스타트업 육성 기관 Y 컴비네이터는 2025년 겨울 기수 스타트업 네 곳 중 한 곳이 코드의 95%를 AI로 만들었다고 밝혔다. 모두 코드를 직접 짤 줄 아는 창업자들이었는데도 그랬다.
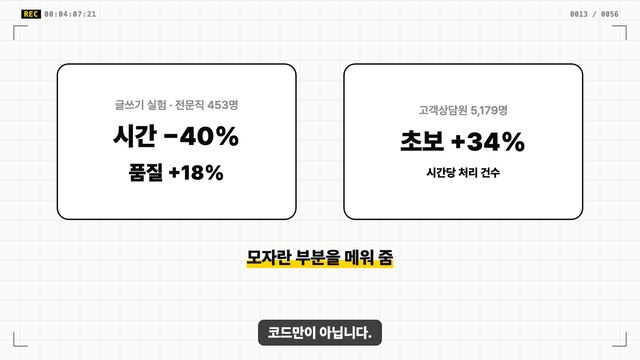
말로 시키는 방식은 코드 바깥으로도 퍼졌다. 전문직 453명이 ChatGPT로 업무 글을 쓴 실험에서는 걸린 시간이 40% 줄고 품질은 18% 올랐다. 고객상담원 5,179명에게 AI 도우미를 붙인 실험에서는 초보와 숙련도가 낮은 상담원의 처리 건수가 34% 늘었다. 문장을 다듬고 형식을 맞추고 경험이 모자란 부분을 메우는 일은 AI가 꽤 많이 보정해 준다는 이야기다.
기획부터 검수까지 말로 지시해 보고 확인한 것
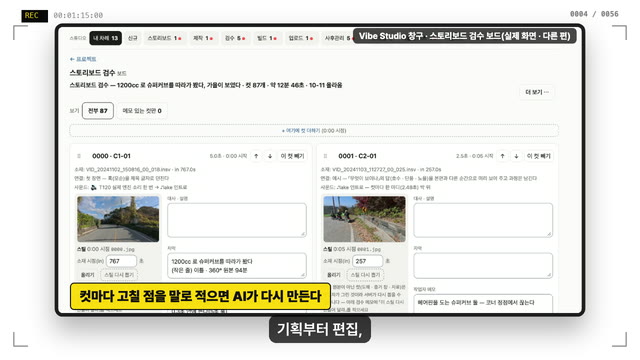
내 작업에서는 이렇다. 이 영상도 기획부터 편집, 검수까지 AI에게 말로 지시해 만들었다. 스토리보드 검수 화면에서 컷마다 고칠 점을 말로 적어 보내면 AI가 다시 만들었고, 기획도 지시가 바뀔 때마다 통째로 새로 쓰였다.
그렇게 일해 보면 금방 알게 되는 것이 있다. 같은 AI라도 원하는 것을 구체적이고 정확한 표현으로 전하면 원하는 결과가 오고, 막연하게 말하면 막연한 결과가 온다.
연구로도 확인된 내용이다. MIT 디지털경제 이니셔티브 연구진이 참여한 실험에서 약 1,900명에게 AI로 그림을 똑같이 다시 만들게 했더니, 더 좋은 AI로 바꿨을 때 늘어난 성과의 절반가량이 사람이 지시문을 고쳐 쓴 데서 나왔다. 가장 잘 지시한 사람은 소프트웨어 엔지니어가 아니라 일상 언어로 생각을 또렷하게 표현하는 사람이었다. 더 좋은 AI를 받은 사람들은 지시문을 24% 더 길게 쓰고 묘사하는 낱말도 더 많이 넣었다.
AI가 대신 메워 주지 못하고 남는 표현 · 판정 · 수정의 힘
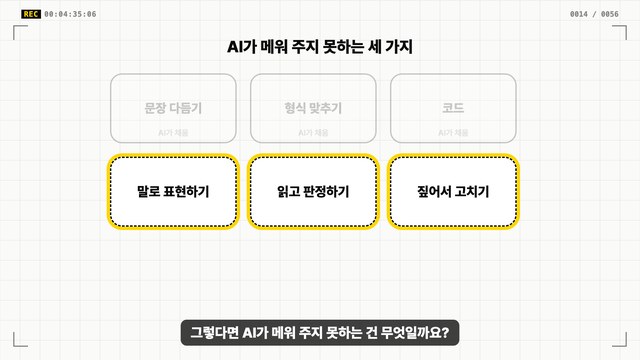
연구들을 모아 보면 AI가 메워 주지 못하는 일이 세 가지 남는다. 무엇을 원하는지 말로 표현하는 것, 돌아온 결과가 맞는지 읽고 판정하는 것, 어디를 어떻게 고칠지 짚어서 말하는 것이다. 영상은 이를 바이브 코딩, 바이브 검수, 바이브 편집이라 부른다.
표현은 같은 AI를 줘도 사람마다 결과가 갈린다는 데서 드러난다. 케냐 창업자 640명에게 AI 멘토를 붙인 실험에서 원래 잘하던 사람은 15% 남짓 좋아졌고 못하던 사람은 8% 정도 나빠졌다. 연구진은 못하던 쪽이 AI에게 더 어려운 문제를 물었다고 봤다.
판정은 하버드 경영대학원과 BCG의 컨설턴트 758명 실험이 보여 준다. AI가 잘하는 과제에서는 평균 아래였던 사람이 43% 좋아졌다. 그런데 AI가 그럴듯하게 틀리는 과제에서는 AI를 쓴 쪽의 정답률이 19%포인트 낮았다. 틀렸다고 판정하지 못하면 AI는 도움이 아니라 함정이 된다.
수정은 구인 플랫폼 사례다. AI 자기소개서 도구가 들어오자 공고에 잘 맞춘 자기소개서가 연락으로 이어지는 연결이 51% 약해졌다. 아직 동료 심사 전인 워킹페이퍼다. 눈여겨볼 점은 AI 초안을 고치는 데 시간을 쓴 사람일수록 채용으로 이어졌다는 것이다.
세 가지는 모두 말과 글로 하는 일이고, 바탕에는 낱말을 아는 정도, 남의 글을 정확히 읽는 힘, 내 생각을 또렷하게 옮기는 힘이 있다.
읽기와 어휘가 내려앉고 있다는 숫자들
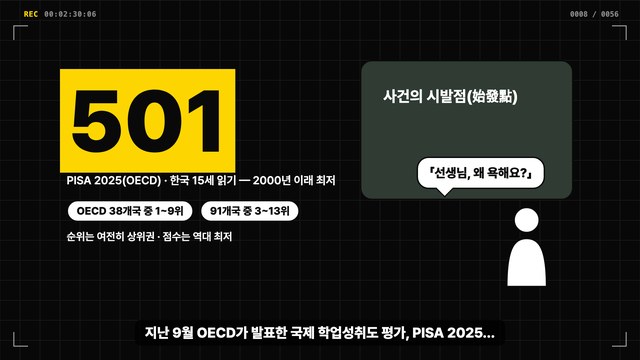
그렇다면 그 바탕은 지금 어떤가. 지난 9월 OECD가 발표한 PISA 2025에서 한국 15세의 읽기 점수는 501점으로, 2000년 조사 이래 가장 낮다. 순위는 표본 오차 때문에 범위로 발표되는데 OECD 38개국 중 1~9위, 91개국 중 3~13위로 여전히 상위권이다. 교실에서는 「사건의 시발점」이라는 말에 선생님이 왜 욕을 하느냐고 되묻는 학생이 있다고 한다.
점수는 2006년 556점으로 세계 1위였다가 2022년 515점, 이번에 501점이 되어 꼭대기보다 55점 낮다.
걱정스러운 쪽은 아래다. 1수준 이하 학생이 14.7%에서 17.8%로 늘고, 상위권은 13.3%에서 10.3%로 줄었다.
국내 평가도 같다. 국어 기초학력에 못 미친 중3이 2017년 2.6%에서 10.1%가 됐다.
교사 5,848명 중 92%가 문해력이 떨어졌다고 답했고, 34.4%는 열 명 중 세 명 이상이 어휘력이 부족하다고 했다. 「금일」을 금요일로, 「중식」을 짜장면으로, 「족보」를 족발보쌈으로 알아들은 사례가 나온다. AI가 돌려준 글에 이런 낱말이 섞여 있다면 맞는지 판정할 수 있을까 하는 물음이 따라온다.
표현력을 재는 국가 통계는 없다. 영상은 읽기와 어휘가 이만큼 내려왔으니 표현의 바탕도 얇아졌다고 보는 게 자연스럽다고 판단했다.
한국만의 일은 아니다. 일본은 516점에서 503점, 싱가포르는 543점에서 535점으로 내려왔다. 그런데 한국은 두 나라보다 점수가 낮고 하락 폭도 14점으로 일본 13점, 싱가포르 8점보다 컸다. OECD 성인역량조사에서 16~24세 언어능력은 293점에서 276점으로 17점 내렸고, 1958~1968년생은 42점 떨어졌다. 성인 독서율 43%는 역대 최저다.
긴 글을 끝까지 따라가는 연습을 밀어낸 환경
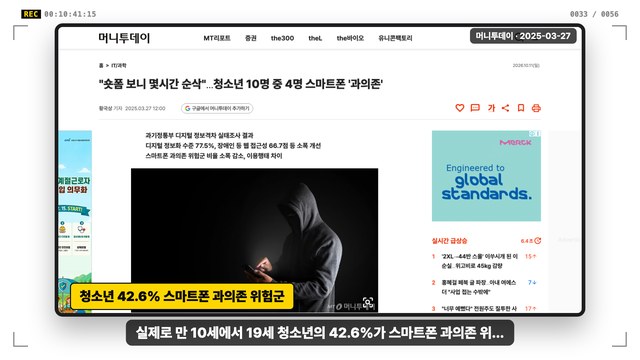
교사들이 꼽은 원인은 디지털 매체 과사용 36.5%, 독서 부족 29.2%다. 교육부도 디지털 매체와 SNS 사용이 늘면서 읽기 동기와 태도에 복합적인 영향을 준 것으로 보인다고 설명했다. 만 10~19세 42.6%는 스마트폰 과의존 위험군이다.
읽는 매체도 차이를 만든다. 연구 54편, 약 17만 명을 모은 분석에서 종이로 읽을 때 이해도가 조금 높았고, 정해진 시간 안에 정보를 담은 설명문을 읽을 때 뚜렷했다. OECD 분석에서는 책을 거의 읽지 않는 학생보다 종이책을 주로 읽는 학생이 49점, 화면으로 주로 읽는 학생이 15점 높았다.
그래서 줄어든 것은 글자를 보는 시간이 아니라, 긴 글을 끝까지 따라가며 뜻을 붙잡고 자기 말로 꺼내 보는 연습일 가능성이 크다. 앞에서 본 AI 시대의 무기를 만드는 연습이 바로 이것이다.
무기가 약한 채 사회의 첫 계단에 서게 될 십 년 뒤
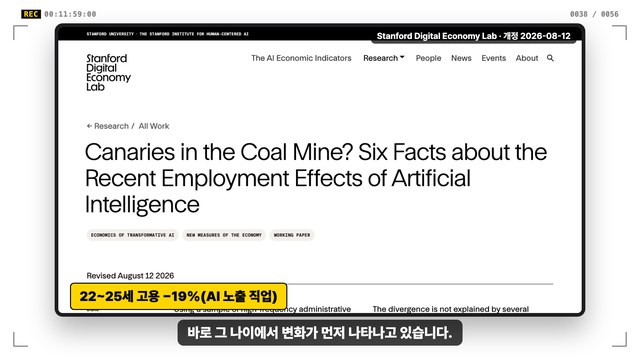
2025년에 시험 본 15세는 2032~2035년에 22~25세가 된다. 스탠퍼드 디지털경제연구소 분석에서 AI 활용이 활발한 직군의 22~25세 고용은 덜 쓰는 직군보다 19% 낮았다. 연구진은 일자리가 크게 대체됐다는 증거는 없다면서도, 변화가 임금이 아니라 고용에서, 초년생 쪽에서 먼저 나타났다고 봤다. 사회로 들어가는 첫 계단이 좁아질 수 있다는 이야기다.
읽기 격차가 AI를 만나 더 벌어질 수도 있다. AI는 잘 다루는 사람을 끌어올리고 못 다루는 사람을 끌어내릴 수 있기 때문이다. MIT 미디어랩의 54명 예비 연구에서는 ChatGPT로 에세이를 쓴 그룹의 뇌 연결성이 가장 약했고, 첫 회차에 83%가 방금 쓴 자기 글을 제대로 인용하지 못했다. 카네기멜런대와 마이크로소프트의 지식노동자 319명 조사는 AI를 더 믿을수록 비판적 사고가 줄었다고 보고했다.
언어능력이 표준편차 하나만큼 높으면 시간당 임금이 8% 높았다. 이 힘은 저절로 자라지도 않는다. 1989~1996년생은 10대 후반·20대 초반에서 20대 후반·30대 초반이 되는 사이 19점이 더 떨어졌다. 지금의 하락은 성적표 한 장의 문제가 아니라 10년 뒤를 미리 보는 일이다.
집과 학교가 다시 쥐여 줄 말과 글의 시간
영상은 앞의 연구에서 끌어낸 제안을 집 네 가지, 학교와 교육당국 네 가지로 나눈다.
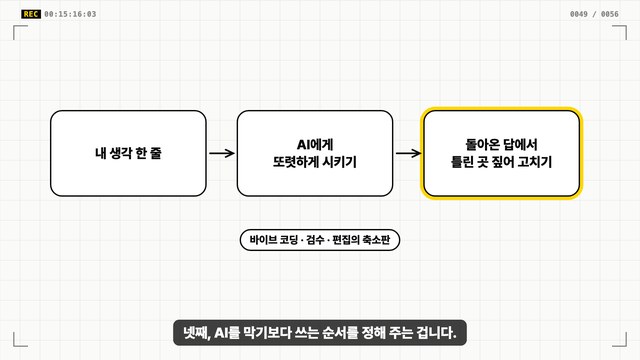
집에서는 먼저 많이 들려주기보다 주고받는 것이다. MIT와 하버드의 4~6세 연구에서 어휘와 언어 능력은 들은 단어 수보다 어른과 말을 주고받은 횟수와 더 강하게 관련됐고, 소득이 낮아도 대화가 많으면 비슷했다. 다음은 종이로 긴 글을 끝까지 읽는 시간을 하루에 조금이라도 만드는 것, 그다음은 부모가 먼저 읽는 모습을 보이는 것이다. 마지막은 AI를 막기보다 쓰는 순서를 정하는 것으로, 내 생각 한 줄을 꺼내고, AI에게 또렷하게 시키고, 돌아온 답에서 틀린 곳을 짚어 고치게 한다.
학교와 교육당국에는 읽기 실력을 일찍, 빠짐없이 진단하자고 한다. 국가수준 평가는 중3과 고2의 3% 표본이라 우리 아이의 위치를 알 수 없다. 화면과 종이도 목적에 맞게 나눠야 한다. 스웨덴은 4학년 읽기가 555점에서 544점으로 내려가자 종이 교과서와 손글씨를 늘렸고, 2023년 교과서 구입에 6억 8,500만 크로나를 배정했다. 평가는 매끈한 결과물보다 초안과 고친 흔적을 함께 보는 쪽으로 바꾸고, 문해력은 국어 시간만의 일로 두지 않는다. 교사들이 꼽은 개선 방안도 독서 활동 강화 32.4%, 어휘 교육 강화 22.6%였다.
501점은 끝이 아니라 경고다. 말이 코딩 언어의 마지막 계단이 된 시대에, 그 말을 다듬는 시간을 누가 아이들에게 돌려줄 수 있을까.